Di tulisan sebelumnya saya bikin rumus sederhana untuk menghitung kapan modal mesin on premise balik. Jawabannya tergantung dua hal: volume percakapan dan kurs.
Kursnya yang terus bergerak. Per Juni 2026, rupiah menyentuh Rp17.980 per 1 USD. Banyak pengamat memperkirakan pelemahan bisa tembus Rp20.000. Tulisan ini melanjutkan hitungan tadi dengan tiga hal yang berubah sejak saat itu.
Rupiah melemah, balik modal makin cepat
Harga token dipatok dalam dolar, jadi tagihan cloud ikut bergerak tiap kali kurs bergerak. Biaya mesin sendiri tidak. Modalnya sudah dibayar dalam rupiah, listriknya ditagih dalam rupiah.
Saya pakai angka yang sama seperti tulisan pertama: 2.500 percakapan per hari, tagihan cloud $630 per bulan, modal Rp60 juta, listrik Rp520 ribu per bulan. Yang saya ubah cuma kursnya.
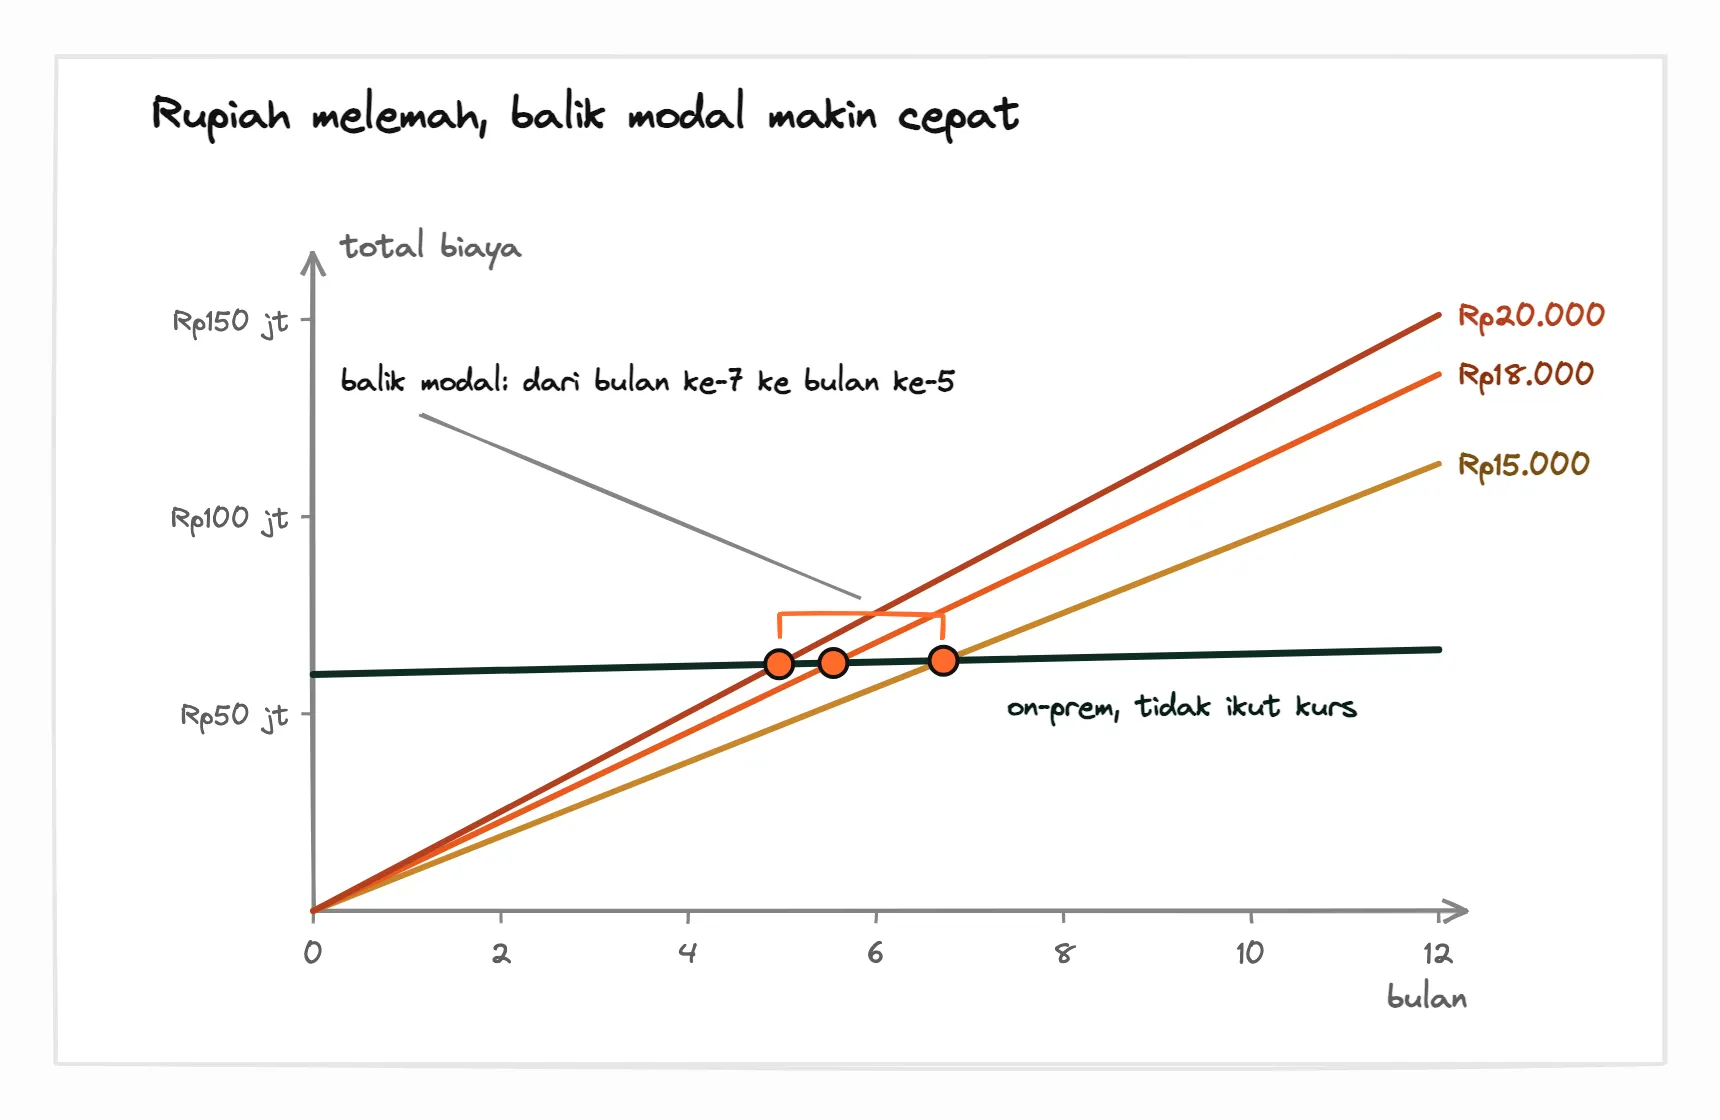
Garis on premise tidak bergerak saat rupiah bergerak. Tiga garis cloud digambar di tiga kurs, dan ketiganya memotong garis on premise di bulan yang berbeda.
Di kurs Rp15.000 per USD, modalnya balik di bulan ke-7. Di Rp18.000, balik di bulan ke-6. Di Rp20.000, balik di bulan ke-5.
Selisihnya memang cuma dua bulan. Tapi arahnya selalu sama, dan itu yang penting. Tiap kali rupiah melemah, keputusan beli mesin jadi lebih gampang dibenarkan, tanpa Anda mengubah apa pun di produk.
Hitungan ini berlaku dua arah, dan itu perlu saya sebut. Kalau rupiah menguat, garis cloud melandai dan balik modalnya jadi lebih lama. Bedanya, modal on premise sudah terlanjur dibayar di depan. Jadi beli mesin itu taruhan bahwa rupiah tidak akan menguat jauh selama umur mesinnya. Lima tahun terakhir taruhan itu benar, tapi tetap saja taruhan.
Ada efek kedua yang lebih jarang dibicarakan. Dengan on premise, pengeluaran bisa dianggarkan jauh ke depan, karena angkanya tidak ikut kurs. Buat perusahaan yang harus mengunci anggaran setahun di depan, kepastian itu ada nilainya.
Model kecil yang lebih jago di satu bidang
Pertanyaan yang paling sering saya dapat adalah soal kualitas. Model yang muat di satu GPU dianggap pasti kalah dari model terbesar di cloud.
Untuk pekerjaan umum, anggapan itu masih benar. Untuk pekerjaan yang sempit, sudah tidak selalu.
Contohnya DharmaOCR, model 3 miliar parameter yang dilatih khusus untuk membaca dokumen. Menurut blog resminya, model itu mengalahkan API frontier komersial di benchmark bidang itu, dan ukurannya cukup kecil untuk jalan di edge device. Saya belum mengetesnya sendiri, jadi anggap itu klaim mereka, bukan hasil tes saya.
Yang menarik bukan modelnya, tapi polanya. Kalau pekerjaan Anda cuma membaca satu jenis dokumen, mengisi satu jenis formulir, atau menjawab pertanyaan soal satu produk, Anda tidak butuh model yang bisa segalanya. Anda butuh model yang tahu satu hal dengan baik, dan model seperti itu muat di mesin yang tadi kita hitung.
Model lokal terus diperbarui tiap bulan
Hal ketiga yang berubah adalah kecepatan rilis. Hampir tiap bulan muncul versi model lokal baru dengan kemampuan reasoning yang lebih baik dari sebelumnya.
Ini mengubah hitungan modal, pelan tapi nyata. Mesin yang Anda beli hari ini akan menjalankan model yang lebih pintar tahun depan, tanpa tambahan modal sepeser pun. Di rumus tadi, b tidak berubah tapi kemampuan mesinnya naik.
Sebaliknya juga benar, dan sudah saya tulis di artikel pertama: mesinnya menua. Dua arah ini saling menutup. Kesimpulan amannya, mesin sendiri tidak secepat itu kehilangan nilai.
Apa saja yang benar-benar jalan di satu mesin
Biar tidak terlalu abstrak, ini pekerjaan yang saya lihat jalan dengan baik di satu mesin GPU tunggal di lingkungan on premise.
Chatbot layanan pelanggan yang menjawab dengan bahasa ramah dan sopan, sampai pelanggan nyaman mengobrol dan akhirnya bertransaksi. Pengecekan resi dan status order yang ditarik langsung dari sistem internal. Pertanyaan soal product knowledge yang dijawab dari dokumen perusahaan sendiri. Pembacaan dokumen dan formulir dengan OCR.
Untuk pekerjaan seperti itu, satu mesin GPU tunggal dengan model 7 sampai 14 miliar parameter yang sudah dikecilkan ukurannya biasanya cukup, di skala ratusan sampai beberapa ribu percakapan per hari. Lewat skala itu, Anda tambah mesin, bukan tambah langganan.
Empat pekerjaan tadi punya satu kesamaan. Semuanya sempit, semuanya berulang, dan semuanya menyentuh data yang sebaiknya tidak keluar kantor. Di situ on premise paling masuk akal, bukan untuk pekerjaan yang bentuknya tidak bisa ditebak.
Kesimpulan
On premise bukan jawaban buat semua orang. On premise cocok untuk volume tinggi, pekerjaan yang sempit, dan data yang tidak boleh keluar.
Kalau tiga hal itu menggambarkan perusahaan Anda, hitung balik modalnya dengan angka Anda sendiri. Kurs hari ini bikin hasilnya lebih cepat dibanding tahun lalu, dan kemungkinan besar lebih cepat lagi tahun depan.